RAG(검색 증강 생성)는 AI가 답하기 전에 관련 자료를 먼저 찾아 읽고 그 근거로 답하는 방식입니다. 동작 5단계, 꼭 필요한지 고르는 기준, 검색 품질을 좌우하는 요소와 답변 검증 체크리스트를 정리했습니다.
이 글은 2026년 10월 12일에 공식 문서와 원 논문을 확인해 쓴 개념 설명입니다. 서비스별 설정값과 가격은 바뀔 수 있으니 실제로 만들 때는 각 회사 문서를 다시 확인해 주세요.
RAG를 한 문장으로 설명하면
RAG(Retrieval-Augmented Generation, 검색 증강 생성)는 AI가 답하기 전에 관련 자료를 먼저 찾아 읽고, 그 자료를 근거로 답을 만드는 방식입니다.
시험에 비유하면 이해가 쉽습니다. 일반적인 챗봇은 외운 지식만으로 푸는 '닫힌 책 시험'에 가깝습니다. RAG는 시험장에 참고서를 들고 들어가, 문제와 관련된 쪽을 펼쳐 보고 답을 쓰는 '열린 책 시험'에 가깝습니다. 참고서를 잘 고르고 필요한 쪽을 정확히 찾을수록 답이 좋아집니다.
이 이름은 2020년 Patrick Lewis 등 연구진이 발표한 논문 「Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks」에서 널리 쓰이기 시작했습니다. 논문은 언어 모델이 학습으로 기억한 지식(파라메트릭 메모리)과 위키백과 문서를 벡터로 바꿔 둔 색인(비파라메트릭 메모리)을 함께 쓰는 구조를 제안했습니다.
왜 필요할까요: 언어 모델이 혼자서는 모르는 것
로컬 LLM이란?에서 설명했듯 LLM은 문맥을 보고 다음에 올 말을 예측하며 문장을 만듭니다. 이 방식에는 구조적인 빈칸이 세 가지 있습니다.
• 학습 이후의 정보: 모델은 학습을 마친 시점 이후에 생긴 일을 모릅니다.
• 나만 가진 자료: 회사 규정, 제품 설명서, 내 메모처럼 공개되지 않은 문서는 학습한 적이 없습니다.
• 근거 표시: 외운 지식으로 답하면 어떤 문서의 어느 부분을 보고 답했는지 보여 주기 어렵습니다.
RAG는 이 빈칸을 '모델을 다시 학습시키는 대신 필요한 자료를 그때그때 건네주는' 방법으로 메웁니다. 자료만 바꾸면 되기 때문에 내용이 자주 바뀌는 문서에 특히 잘 맞습니다.
RAG는 이렇게 동작합니다
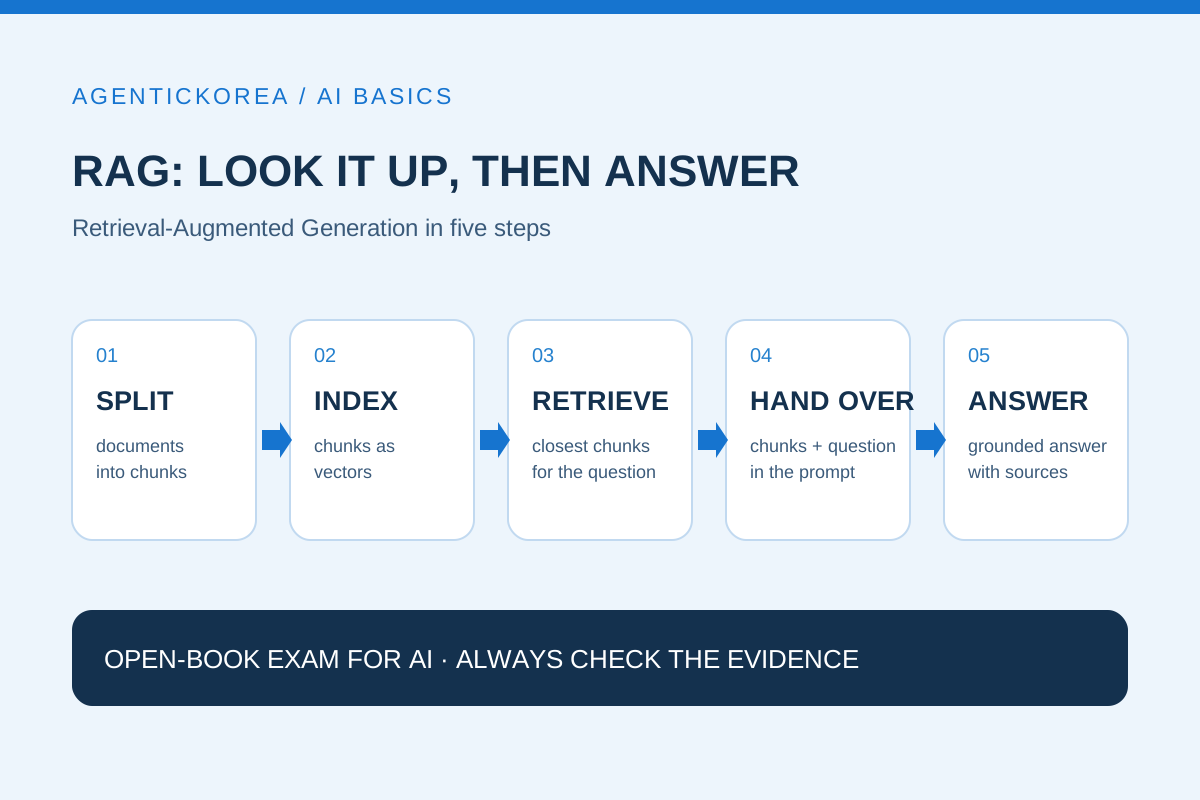
실제 서비스마다 세부 구현은 다르지만 기본 흐름은 비슷합니다.
• 1단계 자르기: 문서를 수백 토큰 정도의 작은 조각(청크)으로 나눕니다. 조각끼리 일부를 겹치게 자르기도 합니다.
• 2단계 색인하기: 각 조각을 임베딩 모델로 숫자 목록(벡터)으로 바꿔 벡터 저장소에 넣습니다. 뜻이 비슷한 문장은 가까운 벡터가 됩니다.
• 3단계 찾기: 질문이 들어오면 질문도 벡터로 바꿔, 가장 가까운 조각 몇 개를 찾습니다.
• 4단계 건네기: 찾은 조각을 질문과 함께 프롬프트에 넣습니다. 예: '아래 자료만 근거로 답하고, 자료에 없으면 모른다고 답하세요.'
• 5단계 답하기: 모델이 건네받은 자료를 읽고 답을 쓰며, 가능하면 어느 조각을 참고했는지 함께 표시합니다.
예를 들어 OpenAI의 벡터 저장소 문서는 파일을 넣으면 자동으로 조각내고 임베딩해 색인한다고 설명하며, 기본 조각 크기를 800토큰, 겹치는 부분을 400토큰으로 안내합니다(2026년 10월 12일 확인). 직접 만들든 서비스 기능을 쓰든 위 다섯 단계가 안에서 일어난다고 보면 됩니다.
RAG가 꼭 필요할까? 고르는 기준
RAG가 항상 정답은 아닙니다. 상황별로 이렇게 나눠 생각해 보세요.
• 자료가 적다면 통째로 넣기: Anthropic은 지식 자료가 약 20만 토큰(약 500쪽) 이하라면 RAG 없이 전체를 프롬프트에 넣는 방법을 먼저 검토하라고 안내합니다.
• 자료가 많고 자주 바뀐다면 RAG: 문서가 계속 늘어나거나 매주 바뀌면 다시 학습하는 것보다 검색해서 건네는 편이 관리하기 쉽습니다.
• 말투·형식을 바꾸고 싶다면 파인튜닝 검토: 파인튜닝은 모델의 답하는 방식을 바꾸는 데 가깝고, 최신 사실을 넣는 용도로는 RAG가 더 직접적입니다.
• 공개된 최신 정보라면 웹 검색: 뉴스나 공개 문서는 웹 검색 기능이 사실상 같은 역할을 합니다. RAG는 주로 내가 가진 자료를 대상으로 합니다.
검색 품질을 좌우하는 세 가지
RAG의 답이 이상할 때 원인은 모델보다 '찾기' 단계에 있는 경우가 많습니다. 처음 만들 때는 다음 세 가지를 먼저 점검하세요.
• 조각 크기와 경계: 너무 작으면 문맥이 끊기고, 너무 크면 관련 없는 내용이 섞입니다. 표나 조항 중간에서 잘리지 않았는지 확인합니다.
• 뜻 검색과 단어 검색 함께 쓰기: 임베딩은 뜻이 비슷한 문장은 잘 찾지만 오류 코드나 제품 번호처럼 정확히 일치해야 하는 말은 놓칠 수 있습니다. 그래서 BM25 같은 단어 기반 검색을 함께 쓰는 하이브리드 검색이 쓰입니다.
• 다시 순위 매기기(리랭킹): 넓게 후보를 찾은 뒤 질문과의 관련도로 다시 정렬해 상위 몇 개만 모델에 건넵니다.
Anthropic이 2024년 9월 공개한 실험에서는 조각마다 앞뒤 맥락 설명을 붙이고(Contextual Retrieval) 단어 검색과 리랭킹을 더하자, 관련 조각을 상위 20개 안에서 찾지 못한 비율이 5.7%에서 1.9%로 줄었습니다. 회사의 자체 실험 조건에서 나온 수치이므로 내 문서에서도 같은 결과가 나온다고 볼 수는 없지만, 찾기 단계를 손보면 결과가 크게 달라질 수 있다는 점은 분명히 보여 줍니다.
예시: 사내 규정 질문 도우미를 만든다면
설명을 위한 가상 예시입니다. 직원 100명 회사가 휴가·출장·경비 규정 PDF 30개로 질문 도우미를 만든다고 해 봅시다.
• 먼저 분량을 잽니다. 전체가 20만 토큰보다 적다면 RAG 없이 전체를 넣고 시작해도 됩니다.
• 분량이 많다면 규정 조항 단위로 조각을 나누고, 각 조각에 '경비 규정 > 출장비 > 숙박' 같은 위치 정보를 붙입니다.
• 프롬프트에 '규정 문서에 없는 내용은 추측하지 말고 담당 부서를 안내할 것'을 넣습니다.
• 답변 끝에 근거 조항 이름을 표시하게 해, 직원이 원문을 바로 확인할 수 있게 합니다.
• 규정이 바뀌면 모델은 그대로 두고 문서만 다시 색인합니다.
RAG 답변을 검증하는 체크리스트
RAG를 쓰면 근거 있는 답이 늘지만, 틀린 조각을 찾아오면 틀린 답도 자신 있게 나옵니다. 결과를 쓰기 전에 다음을 확인하세요.
• 근거 조각이 실제로 질문에 답하는 내용인지 원문을 열어 봅니다.
• 답에 자료에 없는 숫자나 조건이 덧붙지 않았는지 봅니다.
• 같은 질문을 표현만 바꿔 다시 물었을 때 같은 근거가 나오는지 확인합니다.
• 오래된 문서와 새 문서가 함께 색인되어 있지 않은지 점검합니다.
• 개인정보나 권한이 필요한 문서가 검색 대상에 섞이지 않았는지 확인합니다.
정리: RAG는 AI에게 참고서를 건네는 기술입니다
RAG의 핵심은 모델을 바꾸는 것이 아니라 모델에게 건네는 자료를 잘 고르는 데 있습니다. 자료가 적으면 통째로 넣고, 많아지면 조각내 찾아서 건네고, 답은 늘 근거와 함께 확인하는 것이 기본입니다. AI의 구조를 단계별로 더 알고 싶다면 AI 학습 가이드에서 이어서 볼 수 있습니다.
참고한 자료
Lewis et al. — Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (arXiv, 2020) ↗
Anthropic — Introducing Contextual Retrieval (Sep 19, 2024) ↗
OpenAI — Retrieval and vector stores guide (checked Oct 12, 2026) ↗